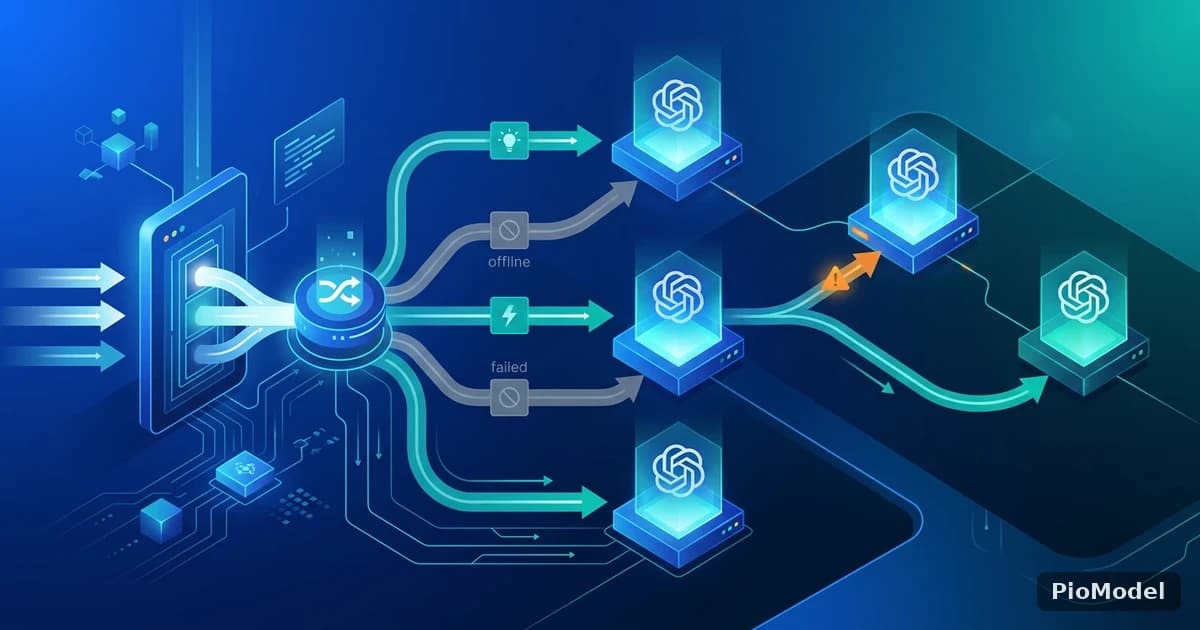
网关侧调度和应用层容错,是两个层次的问题
PioModel 的多渠道调度机制,解决的是网关内部怎么把请求路由到可用的上游资源这个问题,对开发者来说基本是透明的。但这不等于开发者在自己的业务代码里就完全不需要考虑容错——比如你希望主力模型响应异常时,自动换成另一个品牌的模型继续完成这次任务,这种业务级别的策略,是需要在应用层自己写逻辑实现的,网关的调度机制并不知道你的业务对降级到哪个模型有什么偏好。
一个基础故障转移逻辑长什么样
超时或异常怎么判定需要切换
常见的触发条件包括:请求超过你设定的超时时间还没返回、接口返回了明确的错误状态码、返回内容为空或者不符合基本格式要求。把这些情况都归类为这次调用失败、需要考虑切换,而不是只处理其中一种。
主备模型列表怎么设计
按任务重要性和成本预算,提前列一份主模型到备用模型的顺序列表。需要注意的是,不同品牌模型的输出风格和格式可能有差异,设计切换列表时优先选择你已经验证过、输出格式相对接近的模型作为备用,避免切换后下游解析逻辑跟着报错。
关键代码结构
基本流程

基本结构是一个循环:按顺序尝试列表里的每个模型,调用成功就直接返回结果并结束;调用失败(超时、报错、格式不对)就捕获这次异常,继续尝试列表里的下一个模型;如果列表里所有模型都尝试失败,再统一向上抛出错误或返回明确的失败提示,而不是让调用方无限等待。
要不要告诉调用方这次是降级结果
如果业务对用了哪个模型比较敏感(比如不同模型的回答风格差异会影响用户体验),建议在返回结果里附带一个字段标明实际使用的模型,方便上层业务或日志记录知道这次是不是走了降级路径,而不是完全隐藏切换过程。
需要注意的坑
- 重试风暴:如果主模型只是短暂波动,大量请求同时触发切换会瞬间把流量都压到备用模型上,可能连带把备用模型也拖垮,需要考虑加入一定的间隔或熔断机制
- 幂等性:如果任务涉及调用成功后写入数据库这类有副作用的操作,切换重试前要确认清楚上一次调用是不是真的失败了,避免同一个任务被写入两次
- 成本失控:自动切换意味着一次任务可能实际消耗了不止一个模型的调用量,如果没有设置切换次数上限,极端情况下可能比预期成本高出不少
什么场景值得自己做这层,什么场景网关调度就够
| 场景特征 | 建议方案 |
|---|---|
| 只是希望网关内部尽量保证可用性 | 依赖 PioModel 网关侧调度即可,不需要额外开发 |
| 业务上明确要求降级到指定品牌或型号 | 需要在应用层自己实现主备切换逻辑 |
| 任务有严格的输出格式一致性要求 | 建议应用层做,自己控制备用模型的选择顺序 |
| 只是个人项目或原型验证阶段 | 可以先不做,出问题再针对性补充 |
小结

网关侧的多渠道调度和应用层的主备切换,解决的是不同层次的可用性问题,并不冲突,也不能互相替代。是否需要在自己的代码里再加一层容错,取决于业务对失败了具体要怎么降级有没有明确要求,而不是所有场景都值得为容错本身增加复杂度。


Comments
Sign in to join the discussion