视觉多模态能帮你解决什么真实问题
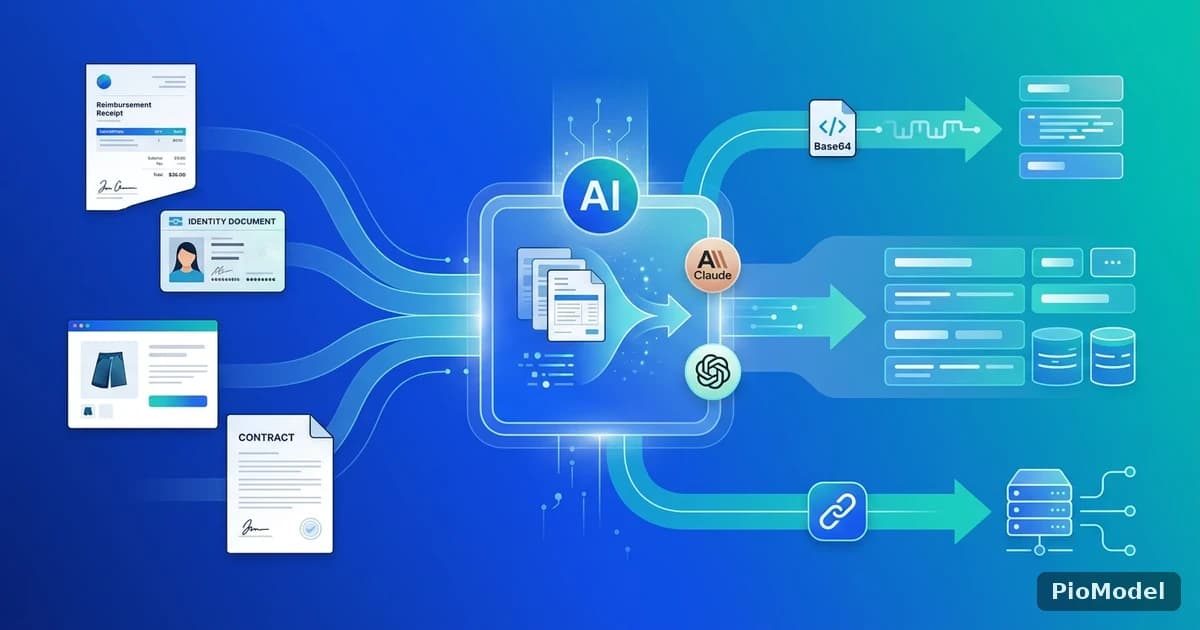
财务报销单、身份证件、产品截图、扫描版合同,这些信息大多以图片或 PDF 形式存在,过去要把它们变成可以入库的结构化字段,要么靠人工手动录入,要么依赖专门的 OCR 服务再自己写规则提取字段。视觉多模态模型出现之后,多了一种新思路:直接把图片丢给具备视觉理解能力的模型,让它“读懂”图片内容并按你要的结构输出,省掉中间那层规则维护的成本。
目前已验证支持视觉理解的模型
需要说明的是,不是所有接入 PioModel 的模型都具备视觉理解能力。目前经过实际测评验证、确认支持图片输入理解的,是 Claude 与 GPT 这两个品牌的对应模型。写具体教程或业务代码前,只应该基于这两个已验证的品牌规划视觉相关功能,不要假设其他模型也具备同等能力。
图片怎么传给模型

Base64 编码方式
把图片文件读取后转成 Base64 字符串,直接嵌入请求体里发送。这种方式不依赖图片能否被公网访问,适合处理用户上传的私密文件,但请求体体积会随图片增大而变大。
图片 URL 方式
如果图片本身已经有一个可公开访问的地址,可以直接把 URL 传给模型,请求体更轻量,但要求这个地址在模型请求时刻是可访问的,不适合处理还没上传到公网的本地文件。
PDF 与实战:从页面渲染到结构化提取
PDF 怎么处理
目前视觉理解接口主要面向图片输入,PDF 本身不是图片格式,常见做法是先把 PDF 的每一页渲染成图片,再按图片的方式逐页处理,最后把各页的解析结果按顺序拼接或合并成完整文档的结构化数据。页数较多的文档,建议先评估处理成本,不必要的整份文档都处理时,可以先用简单规则筛出确实需要视觉解析的页面。
发票场景实战:从图片提取结构化字段
把一张发票图片和一份定义好“发票代码、金额、开票日期”等字段的 JSON Schema 一起传给模型,模型会结合图片内容和字段定义,尝试按要求的结构返回结果,拿到的输出可以直接进入后续的财务系统或表格,不需要人工逐项抄录。
常见误区
| 误区 | 实际情况 |
|---|---|
| 把视觉理解等同于传统 OCR | 视觉理解模型是在理解画面内容基础上生成回答,精确的逐字符定位识别未必是它的强项,复杂版式的极致精度场景仍可结合专门 OCR 工具 |
| 认为所有模型都支持图片输入 | 目前只有经过验证的 Claude、GPT 对应模型确认支持,其他品牌接入前不应默认具备该能力 |
| 图片分辨率越高效果一定越好 | 图片过大会增加处理成本和延迟,超过实际需要的分辨率往往只是浪费,清晰可读即可 |
小结

把图片和 PDF 解析成结构化数据,核心流程是图片编码传参、视觉理解模型、结构化输出约束三者结合,目前只应该基于已验证支持视觉能力的 Claude、GPT 对应模型规划这类功能。批量处理前,先用小范围样本跑通整条链路,确认解析准确率符合预期,再考虑接入正式业务流程。


Comments
Sign in to join the discussion