为什么开发者开始用 AI API 网关?
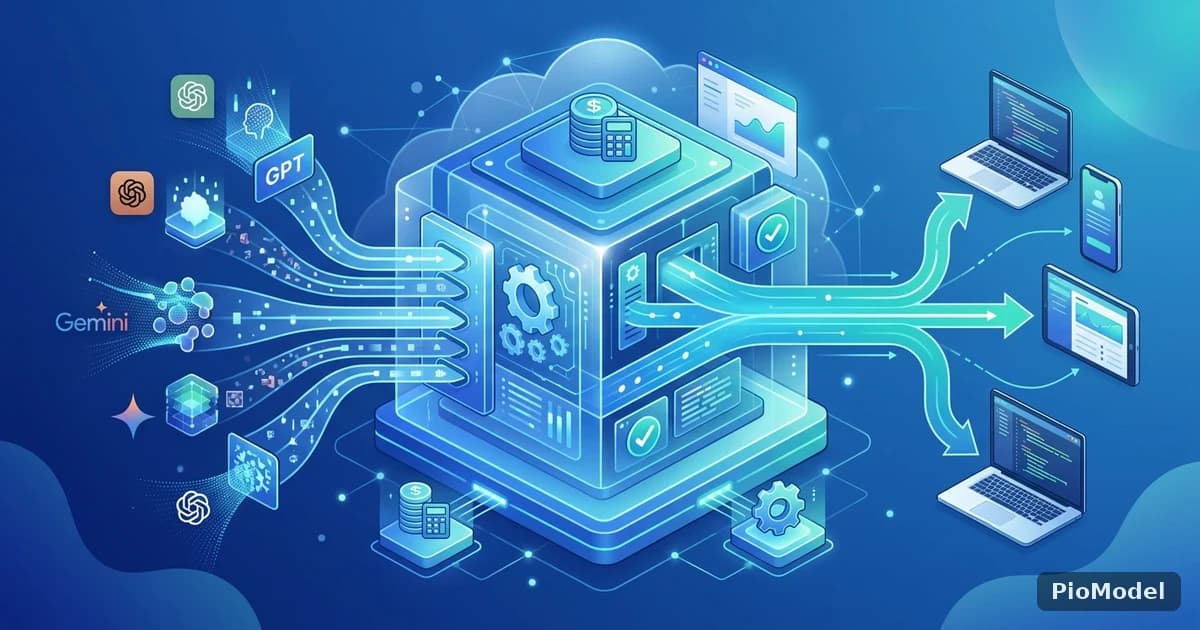
答案很直接:单一模型厂商已经很难覆盖生产环境的稳定性、成本和多模型测试需求。AI API 网关用一个密钥统一接入 GPT、Claude、Gemini 等主流模型,自动处理格式转换、限流和账单核算,把原本分散在多个厂商控制台的运维工作收敛成一个入口,这是它逐渐被写进新项目技术选型清单的直接原因。
单模型依赖带来的三个真实痛点
多账号维护成本被低估
只接入一家模型厂商,看起来省事,但团队一旦同时评估 GPT 和 Claude 的效果差异,就要维护两套 API Key、两套 SDK 调用方式、两份账单对账逻辑。人力成本不会体现在架构图上,但会实实在在地占用工程师的时间——尤其是当某个模型厂商调整接口字段或者废弃某个参数时,排查改动影响往往要花上半天。
限流和单点故障直接影响线上体验
大部分模型厂商都有并发和速率限制,遇到流量高峰或者厂商侧临时限流,直连的应用会直接收到 429 错误。如果没有备用通道,用户看到的就是功能不可用。对于已经把 AI 能力做进核心功能的产品,这种单点故障的代价比想象中要高。
计费口径不透明,成本很难预测
输入输出分别计价、长文本和短文本价格不同、部分厂商还有阶梯定价——不对齐账单口径,月底核算成本时经常出现"这个月为什么多花了三成"的疑问,却找不到具体是哪个调用场景导致的。
聚合网关具体解决了什么问题
统一密钥与双格式兼容
大多数聚合网关同时兼容 OpenAI 和 Anthropic 两种调用格式,已经写好的 OpenAI 风格代码,只需要替换 base_url 和 model 参数就能调用 Claude,不需要重写消息结构。这对已经有存量代码的团队尤其友好,迁移成本几乎可以忽略。
倍率计费让成本可预测
以 PioModel 为代表的聚合网关采用 model_ratio(模型倍率)、completion_ratio(补全倍率)、cache_ratio(缓存命中倍率)叠加计费的方式,不同模型的定价差异直接体现在倍率上,团队可以在调用前就估算出成本区间,而不是等账单出来才知道花了多少。额度来源上,钱包按量充值和包月订阅套餐可以并存,按量测试新模型、订阅覆盖稳定的日常调用量,两种方式配合能进一步压低平均成本。
路由与容灾能力
当某个模型厂商出现延迟升高或者服务不稳定,网关层可以做路由切换,而不需要业务代码感知具体是哪个厂商在处理请求。这层抽象是聚合网关相比直连最直接的稳定性收益。
选型时该看哪些维度
不是所有聚合网关都值得接入,选型时建议至少对比以下几个维度:
| 维度 | 直连原厂 API | AI 聚合网关 |
|---|---|---|
| 接入成本 | 每家厂商单独接入,SDK 和鉴权方式不同 | 一个密钥,OpenAI/Anthropic 双格式兼容 |
| 故障切换 | 需要自己写降级逻辑 | 网关层路由,业务代码无感知 |
| 计费方式 | 按厂商各自口径,难以横向比较 | 统一倍率体系,成本可预估 |
| 多模型测试 | 需要维护多套调用代码 | 切换 model 参数即可对比效果 |
| 账单可追溯性 | 依赖厂商控制台,分散查询 | 统一账单和调用日志 |
如果团队只调用单一模型、且已经有稳定的直连合作关系,聚合网关不一定是刚需;但只要涉及多模型对比、或者对稳定性有明确要求,这几项差异就会逐渐变成决定项目进度的关键因素。
常见问题
聚合网关会不会增加请求延迟?
网关层会引入一次转发,但主流聚合网关都做了网络链路优化,实际增加的延迟通常在可接受范围内,具体表现因网关的骨干网络部署而异,建议接入前用真实场景做一次延迟测试。
聚合网关的计费会不会比直连更贵?
不一定。聚合网关通常有阶梯折扣和批量采购价格优势,叠加倍率计费的透明度,很多场景下综合成本反而低于直连自己处理限流重试的隐性成本,具体价格以各家网关官网价格页为准。
已经写好的 OpenAI SDK 代码需要重写吗?
如果聚合网关支持 OpenAI 兼容格式,通常只需要替换 base_url 和 API Key,不需要重写消息结构和业务逻辑。
企业客户能不能用统一账号管理多个项目的密钥?
可以,多数面向企业的聚合网关提供子密钥隔离和用量限制功能,方便按项目或按团队拆分密钥并分别设置额度上限。
总结
AI API 网关成为趋势,本质是开发者在用更低的运维成本换取多模型灵活性和线上稳定性。如果团队正被多账号维护和计费口径不透明困扰,不妨看看 PioModel 这类聚合网关的倍率计费和双格式兼容方案是否适合当前项目。


Comments
Sign in to join the discussion