AI 网关的多模型智能路由到底在解决什么问题?
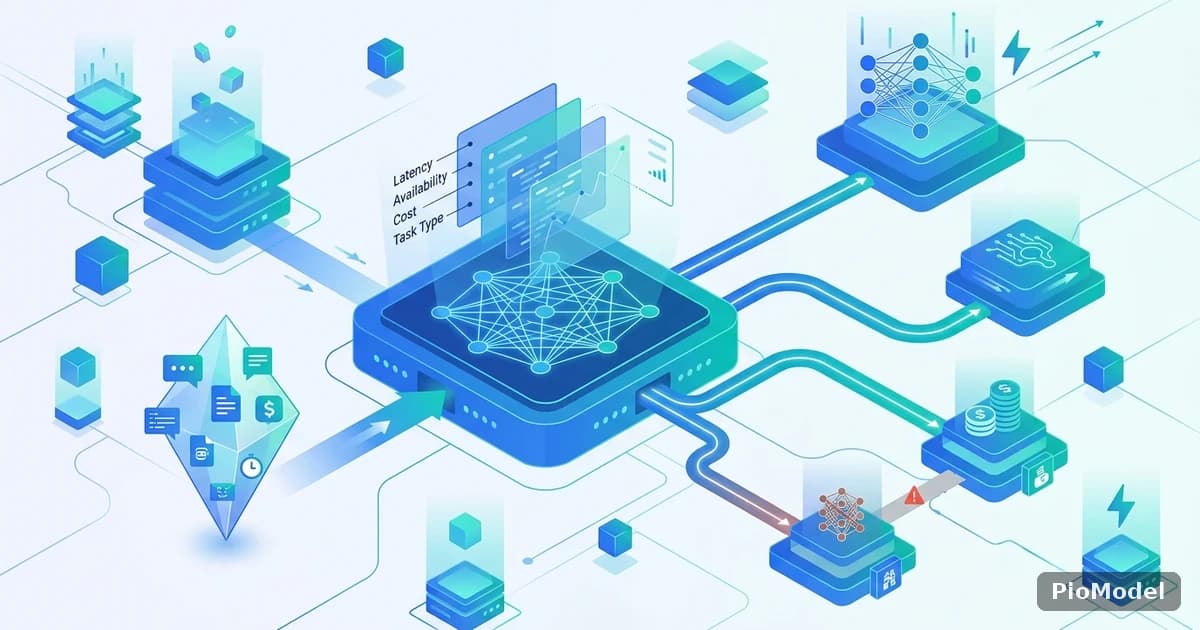
多模型路由技术,指 AI 网关收到调用请求后,不把请求写死发给某个固定模型,而是根据延迟、可用性、成本、任务类型等条件,自动决定这次请求由哪个模型或上游节点处理。开发者只对接一个统一入口,模型的自动择优、故障切换都交给网关层完成。
为什么单一模型供应商不够用
供应商级故障和限流是常态,不是意外
任何一家模型厂商都会遇到区域性故障、临时限流、模型版本下线这类情况。如果业务只接了一家的 API,一旦对方出问题,整个功能直接不可用。多模型路由的第一个价值,就是把「单点依赖」变成「多个可替换节点」,某个上游异常时自动换一个能用的继续跑。
不同模型的能力和价格天然不对等
擅长推理的模型不一定擅长长文本摘要,响应快的模型不一定最便宜。业务里经常需要按任务类型挑模型:简单分类用便宜快速的小模型,复杂推理用能力更强但更贵的模型。手工维护这套映射关系,规则一多就很难管理。
路由决策通常依据哪些维度
一个可用的路由策略,一般会综合以下几类信号,而不是只看单一指标:
- 延迟与可用性:近期请求的响应时间、失败率、超时次数;
- 成本权重:不同模型的倍率计费差异,以及是否命中缓存(cache_ratio 影响的部分);
- 任务类型匹配:代码生成、长文本、多轮对话等场景对模型能力的不同要求;
- 限额与配额状态:某个上游账号是否临近限流阈值。
延迟与可用性探测怎么做
网关通常会持续采集每个上游节点的响应时间和错误率,形成一个滚动更新的健康分数。分数低于阈值的节点会被临时降权甚至摘除,恢复正常后再重新纳入可选范围,这个过程对调用方是无感的。
成本与倍率计费怎么参与决策
在采用 model_ratio、completion_ratio、cache_ratio 这类倍率计费体系的网关里,同一次任务用不同模型完成,实际扣费可能差好几倍。路由策略如果把成本也纳入考量,就能在效果达标的前提下,优先选择倍率更低的模型,而不是一律路由到最贵的旗舰模型。
常见的路由策略与实现方式
| 策略类型 | 核心逻辑 | 适合场景 |
|---|---|---|
| 静态规则路由 | 按预设优先级顺序尝试 | 模型能力差异小、追求配置简单 |
| 动态权重路由 | 按实时延迟/成功率调整权重 | 上游节点数量多、稳定性波动大 |
| 成本优先路由 | 效果达标前提下选倍率更低的模型 | 调用量大、对成本敏感的业务 |
| 健康检查+故障转移 | 探测异常节点并自动切换 | 对可用性要求高的生产环境 |
以健康检查加自动故障转移为例
PioModel 这类聚合网关实现的智能故障转移,大致原理就是上面提到的健康分数机制:某个上游模型连续出现超时或 5xx,网关会在下一次请求时自动路由到功能相近的备用节点,同时把这次异常记录进用量分析,方便开发者事后复盘是偶发波动还是某个供应商的持续性问题。
小结
多模型智能路由的核心,是把延迟、成本、任务匹配这几类原本要靠人工判断的决策,交给网关层持续计算并自动执行。如果团队正在维护多个模型供应商的调用逻辑,不妨了解一下带智能路由能力的网关方案,减少自己重复造轮子的部分。
常见问题
智能路由会不会导致每次调用结果不一致?
路由影响的是请求被发到哪个上游节点,只要目标模型版本一致,输出的随机性主要还是来自模型本身的采样参数,和是否走智能路由关系不大。如果业务要求严格复现,可以在调用时显式指定模型而不走自动路由。
路由到备用模型时价格会不会变化?
会。不同模型的倍率不同,故障转移到的备用模型如果和主模型不是同一价位,实际扣费会随之变化,建议在用量分析里关注这部分差异,避免长期停留在成本更高的备用节点上。
开发者能否手动指定某次调用只用某个模型?
可以。多数网关都支持在请求里显式指定模型名称,这种情况下路由逻辑会跳过自动择优,直接按指定模型处理,智能路由更多是在没有强制指定时发挥作用。
路由和缓存命中倍率是什么关系?
缓存命中倍率(cache_ratio)影响的是同一段上下文重复调用时的计费方式,和路由选哪个模型是两个独立维度,但路由策略如果考虑了成本因素,理论上会倾向于把可复用上下文的请求路由到同一节点以提高缓存命中率。


Comments
Sign in to join the discussion