为什么前端/全栈开发者也需要关心模型接入这件事
大多数模型接入教程都是面向后端或 CLI 工具写的,但如果你在用 Next.js 做一个带 AI 功能的产品,真正要解决的问题是怎么把流式回复实时显示在页面上,而不只是怎么发一个请求。Vercel AI SDK 正是为这类场景设计的工具包,封装了从服务端拿到流式响应、再同步更新到前端界面的整套逻辑,不用自己手写 SSE 解析。
核心概念速览
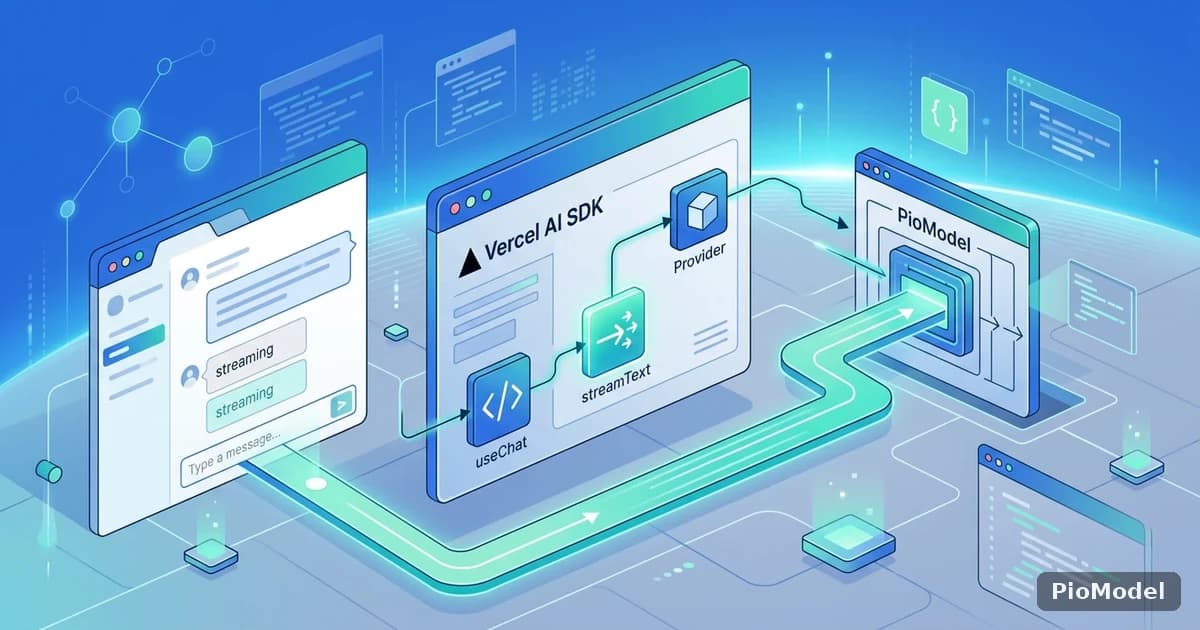
用之前先弄清楚三个概念:Provider(模型来源,比如 openai 这个包)、streamText(在服务端发起流式请求的函数)、useChat(在前端组件里消费流式结果的 Hook)。这三者配合起来,才是一次完整的用户输入-服务端调用模型-页面逐字显示链路。
用 createOpenAI 把 PioModel 接进来

环境变量怎么设置
在项目的环境变量里新增一个变量存放 PioModel 的密钥(比如 PIOMODEL_API_KEY),不要把密钥直接写死在代码里,尤其是会打包到前端的文件中。
API Route 里怎么写
在服务端的 API Route 里,用 @ai-sdk/openai 提供的 createOpenAI 函数创建一个实例,把 baseURL 指向 PioModel 的接口地址,apiKey 读取上面配置的环境变量,再用这个实例调用 streamText 发起请求,拿到的流式结果直接作为响应返回给前端。
前端怎么消费流式输出
前端组件里用 useChat 这个 Hook 指向刚才写的 API Route,它会自动处理消息状态管理和逐字追加显示,不需要手动拼接文本片段。
常见问题:为什么没有逐字吐出来,而是一次性整段出现
这种情况通常出在两个地方:一是服务端返回时没有用流式响应格式,而是等模型完全生成完才一次性返回;二是 PioModel 对应的接口本身是否支持流式参数需要在请求里显式声明,如果只支持非流式返回,现象上也会表现成一次性出现。遇到这种情况先确认请求里流式参数是否传对,再确认前端渲染逻辑有没有等待整个响应结束才渲染。
为什么不建议在前端直接调用 PioModel
把 API Key 直接放进前端代码调用 PioModel 接口,密钥会随浏览器请求暴露给任何打开开发者工具的人。正确做法是密钥只保存在服务端环境变量里,前端只和自己的 API Route 通信,由服务端代持密钥去调用 PioModel,这也是上面架构里用 API Route 中转的核心原因。
多模型切换在前端怎么做
| 方式 | 做法 |
|---|---|
| 下拉框选模型 | 前端维护一个模型列表,选中后把对应 model 参数传给 API Route |
| API Route 内路由 | 根据请求体里的 model 字段,决定传给 streamText 的具体模型名 |
| 按场景固定模型 | 不同功能页面直接在代码里写死适合该场景的模型,不暴露选择给用户 |
| 按成本预算选择 | 先用低成本模型处理简单请求,复杂请求再升级调用更强模型 |
小结

Vercel AI SDK 把发起流式请求和前端消费流式结果这两件麻烦事都封装好了,接入 PioModel 只是把 Provider 的 baseURL 和 apiKey 指向正确的地方。真正需要花心思的,是环境变量的安全存放和多模型场景下的路由设计,而不是接口调用本身。


评论
登录后可参与评论