PioModel 支持哪些模型?
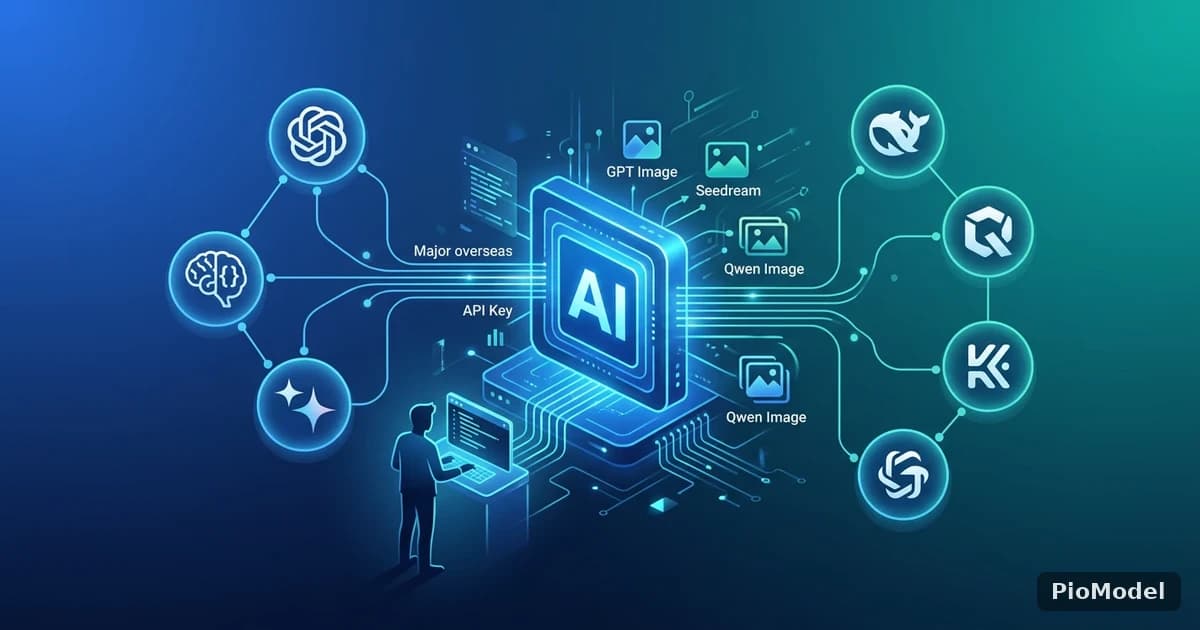
PioModel 通过统一的 OpenAI 兼容接口,聚合了 Claude、GPT、Gemini 等海外主流模型,也接入了 DeepSeek、Qwen、Kimi、GLM 等国产大模型,同时覆盖 GPT Image、Seedream、Qwen Image 等多模态生图模型。也就是说,开发者不需要分别对接每家厂商的原生 API 和认证方式,只用一个 API Key、一套请求格式,就能按需调用不同厂商的模型。具体可用模型的数量和版本更新较快,以官网模型列表页的实时数据为准,下面按模型家族梳理接入清单和典型使用场景。
海外主流模型接入情况
Claude 系列
Claude 系列模型在长上下文理解、复杂推理和代码类任务上表现稳定,PioModel 原生支持 Claude Code 这类基于 Claude 的开发工具直接接入,不需要额外改动业务逻辑就能把现有 Claude Code 配置指向 PioModel 的网关地址。
GPT 系列
GPT 系列是目前生态最成熟、第三方工具适配最广泛的模型家族之一,PioModel 对 GPT 系列的文本模型和图像模型(GPT Image)都做了接入,适合已经基于 GPT 生态搭建业务、想要统一网关管理成本和可用性的团队。
Gemini 系列
Gemini 系列同样在 PioModel 的支持范围内,和其他模型一样走统一的 OpenAI 兼容接口调用,不需要单独对接 Google 的原生 SDK。
Grok / Llama / Mistral
除了前面三家,PioModel 也接入了 Grok、Llama、Mistral 等模型,方便有多样化模型选型需求(比如做横向效果对比或成本对比)的开发者在同一个账号体系下试用不同模型,不用为每家单独注册账号。
国产大模型接入情况
| 模型家族 | 典型特点 | 适合场景 |
|---|---|---|
| DeepSeek | 代码与推理能力突出,成本相对可控 | 代码生成、逻辑推理类任务 |
| Qwen(通义千问) | 模型版本和参数规模覆盖较全 | 通用文本任务、多语言处理 |
| Kimi | 长上下文处理是主打能力之一 | 长文档摘要、长对话场景 |
| GLM | 中文语义理解针对性优化 | 中文为主的业务场景 |
多模态与生图模型接入情况
除了纯文本对话模型,PioModel 也接入了 GPT Image、Seedream 4.0、Qwen Image Max 等生图模型,同样通过统一接口调用,适合需要在同一套计费和调用体系里,既处理文本任务又处理图像生成任务的团队,不用为图像生成单独对接另一套 API 和账号。
怎么根据业务场景选模型
代码类任务优先看长上下文与推理能力
涉及大型代码库理解、多文件重构这类任务,更适合选长上下文窗口和推理能力较强的模型家族,比如 Claude 系列或 DeepSeek 的推理向版本。
成本敏感场景可以先做倍率对比
不同模型的 model_ratio 差异较大,如果预算有限,建议先用小批量请求实测几个候选模型的实际效果和倍率成本,再决定长期使用哪一个,而不是只看模型知名度做选择。
中文场景优先考虑国产模型的语义适配
面向中文用户的业务,GLM、Qwen 这类针对中文语义优化过的模型,在部分场景下的理解准确度可能优于纯海外模型,值得纳入对比范围。
常见问题
PioModel 的模型列表会经常更新吗?
会。模型厂商本身在持续发布新版本,PioModel 的可用模型清单也会同步调整,具体以官网模型列表页当前显示的内容为准。
不同模型的调用参数格式一样吗?
PioModel 统一走 OpenAI 兼容接口,基础参数格式是一致的,但个别模型的特殊能力(比如某些模型独有的参数)可能需要参考对应模型的补充说明。
Claude Code、Cursor 这类工具怎么接入 PioModel?
通常只需要把这些工具原本指向官方 API 的地址和密钥,替换成 PioModel 提供的网关地址和 API Key,具体配置步骤以官网接入文档为准。
国产模型和海外模型的计费方式一样吗?
都遵循同一套 model_ratio/completion_ratio/cache_ratio 倍率计费框架,但具体倍率数值因模型而异,以账单页实际扣费为准。
总结
PioModel 把 Claude、GPT、Gemini 等海外模型和 DeepSeek、Qwen、Kimi、GLM 等国产模型放进了同一套接口和账号体系,省去了分别对接多家厂商的重复工作。具体选哪个模型,建议结合任务类型和倍率成本做小范围实测,再决定长期使用哪一个。


评论
登录后可参与评论