PioModel 的 Embedding 接口怎么接入向量数据库?
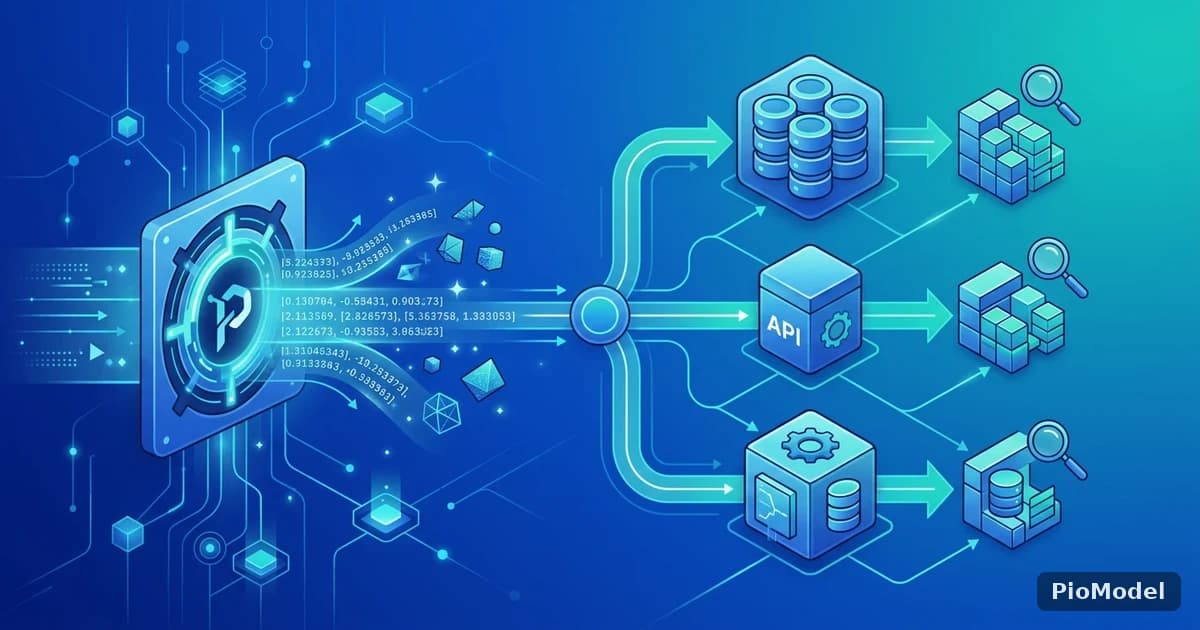
PioModel 走的是 OpenAI 兼容的调用格式,接入向量数据库的思路和用 OpenAI SDK 直连是一致的:替换 base_url 和 API Key 后调用 embedding 接口拿到向量,再写入 Milvus、Qdrant 或 pgvector 这类向量数据库做检索。
接入前要确认的两件事
确认目标 embedding 模型是否可用
不同网关支持的 embedding 模型范围不完全一样,接入前建议先在 PioModel 官网的模型列表里确认目标模型是否在支持范围内,以及对应的向量维度——向量维度直接决定后面向量数据库的字段定义,选错了要重新建表重新灌数据,返工成本不低。
确认向量数据库的选型
Milvus、Qdrant、pgvector 是目前比较常见的三个选择:Milvus 适合数据量大、需要精细调优索引的场景;Qdrant 部署简单、API 友好;pgvector 的优势是可以直接复用现有 PostgreSQL 实例,不用额外运维一套新的数据库。团队技术栈里已经有 PostgreSQL 的,pgvector 通常是改造成本最低的选项。
接入流程实战
第一步:替换 base_url 调用 embedding 接口
如果原来的代码是用 OpenAI SDK 调用 embedding 接口,迁移到 PioModel 的改动通常只涉及初始化客户端时的两个参数:
- 把 base_url 指向 PioModel 的网关地址(以官网文档公布的地址为准)
- 把 api_key 换成在 PioModel 控制台生成的密钥
- 调用 embedding 接口传入待向量化的文本,拿到返回的向量数组
第二步:批量向量化并写入向量数据库
实际项目里通常是先对文档做分片(chunk),再批量调用 embedding 接口,把每个分片对应的向量连同原文和元数据(来源文档、分片序号)一起写入向量数据库。批量调用时要注意接口的单次请求数量上限和限流策略,一次性塞入过多文本容易触发限流报错,建议分批次提交并加入失败重试。
第三步:检索时的查询向量化
用户发起检索请求时,需要用同一个 embedding 模型把查询文本转成向量,再去向量数据库里做相似度检索。这里最容易踩的坑是检索阶段换用了和建库阶段不同的 embedding 模型——两个模型的向量空间并不通用,混用会导致检索结果完全不相关。
常见踩坑与排查思路
- 向量维度不匹配:建表时的维度定义和实际返回的向量长度不一致,写入会直接报错,需要在建表前用一次真实调用确认维度
- 建库和检索用了不同模型:检索结果相关性差,优先检查两端调用的 embedding 模型名称是否完全一致
- 批量调用触发限流:大批量导入历史文档时,建议控制并发数并加入指数退避重试,而不是一次性并发拉满
- 文本分片粒度不合理:分片过大会让向量语义过于宽泛,分片过小又会丢失上下文,需要结合具体文档类型调整分片长度
常见问题
PioModel 支持哪些 embedding 模型?
具体支持的 embedding 模型以官网模型列表页的实时信息为准,不同模型的向量维度和定价存在差异,接入前建议先核实清楚。
已经用 OpenAI SDK 写好的 embedding 调用代码需要重写吗?
如果走的是 OpenAI 兼容格式,通常只需要替换 base_url 和 api_key,不需要重写调用逻辑和数据处理部分。
向量数据库应该选 Milvus、Qdrant 还是 pgvector?
没有绝对最优解,数据量大且需要精细调优可以选 Milvus,想要部署简单选 Qdrant,已经在用 PostgreSQL 的团队用 pgvector 改造成本最低。
embedding 调用的成本怎么控制?
可以从减少重复向量化入手,比如对内容没有变化的文档跳过重新计算,同时结合 PioModel 的倍率计费机制,在官网价格页确认目标模型的具体定价再评估调用规模。
总结
接入 PioModel 的 Embedding 接口,核心工作量集中在确认模型和向量维度、以及向量数据库的选型上,调用方式本身因为兼容 OpenAI 格式而改动很小。如果团队正在搭建检索增强应用,可以从一次小规模的模型可用性验证开始。


评论
登录后可参与评论