PioModel API 响应慢,第一步该查什么?
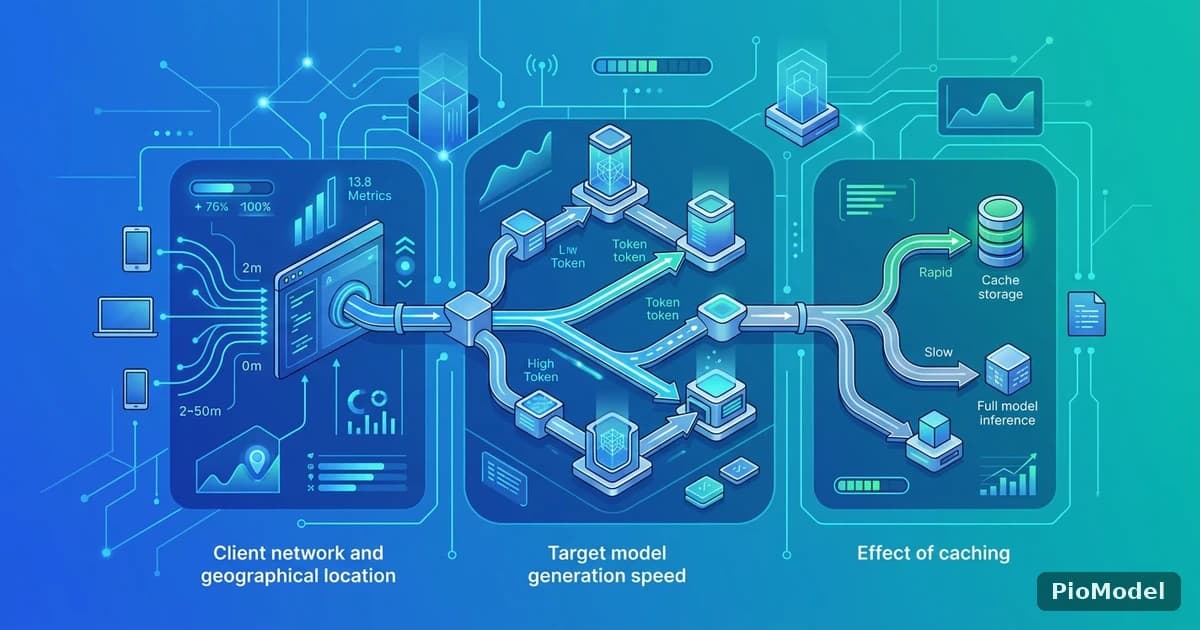
PioModel 响应慢,通常不是单一原因造成的,可能出在客户端网络、目标模型本身的生成速度、是否命中缓存这三个环节里的任意一个。排查的正确顺序是先分清延迟发生在请求链路的哪一段,再针对性处理,而不是一上来就怀疑是网关或某个模型有问题。本文按环节拆解排查步骤,并给出几个能直接优化延迟的具体做法。
先定位延迟发生在哪个环节
客户端网络与地理位置
如果客户端所在地区到网关的物理链路本身延迟就高,任何优化都很难把总耗时降下来。可以先用简单的网络工具测一下到网关域名的基础往返时间,如果这部分已经占了大头,优化方向应该是链路层面,而不是应用层的调用逻辑。
模型本身的生成速度差异
不同模型的生成速度天然不同,参数规模更大、推理更复杂的模型,单位 token 的生成耗时通常也更长。同一段 prompt 换一个轻量模型跑一遍,如果耗时明显下降,说明延迟主要来自模型本身而不是网关转发。
是否命中缓存影响响应速度
在有 cache_ratio(缓存命中倍率)机制的计费体系里,命中缓存的请求通常处理路径更短、返回也更快。如果同样的上下文反复调用却一直没有降速,可以检查一下请求结构是否稳定,避免每次都因为微小差异导致缓存判定失败。
具体排查步骤
遇到响应慢的问题,建议按下面的顺序逐步排查:
- 用最小化的请求(短 prompt、单轮对话)复现问题,排除是不是业务侧传参过大导致;
- 分别测试流式(stream)和非流式响应,对比首字返回时间和总耗时;
- 更换一个不同的模型发起同样的请求,判断延迟是否和具体模型绑定;
- 打开 PioModel 后台的用量分析面板,查看对应时间段的请求记录和响应时间分布;
- 如果是间歇性变慢,记录发生的具体时间点,方便和面板里的异常时段做对照。
用量分析面板能帮上什么忙
比起在业务代码里自己埋点计时,直接看 PioModel 后台的用量分析往往更快定位问题:能看到是所有模型都变慢,还是集中在某一个模型上;是持续性的还是某个时间段的异常波动。这一步经常能帮忙把「感觉变慢了」这种模糊描述,转化成具体是哪个模型、哪个时间段出的问题。
可以采取的优化手段
更换同能力档位但速度更快的模型
如果业务对具体是哪个模型没有强绑定要求,而是要一个「效果够用、速度更快」的选项,可以在能力相近的几个模型之间做 A/B 测试,选一个延迟更稳定的作为默认模型。
合理设置超时与重试
超时时间设置得过短,会把「模型本身生成较慢」误判成「请求失败」进而触发不必要的重试,反而加重整体延迟和成本;设置得过长,又会让用户长时间等待没有反馈。建议按 P95 响应时间留出合理余量,而不是拍脑袋定一个固定值。
利用智能故障转移避开异常节点
如果延迟问题集中在某个上游节点的阶段性异常,PioModel 网关的智能故障转移机制会在探测到该节点响应恶化时自动切换到其他可用节点,这种情况通常不需要业务代码介入,但建议同步关注一下用量分析里是否有对应的切换记录。
常见现象与处理方式对照
| 现象 | 可能原因 | 处理方式 |
|---|---|---|
| 所有请求普遍偏慢 | 客户端到网关的网络链路延迟高 | 测试基础网络延迟,评估链路优化空间 |
| 只有某个模型慢 | 该模型本身生成速度较慢 | 更换同档位速度更快的模型 |
| 首字慢、后续正常 | 未使用流式返回 | 改用流式(stream)接口 |
| 间歇性变慢 | 上游节点阶段性异常 | 结合用量分析确认后依赖故障转移机制 |
小结
PioModel 响应慢的排查思路,核心是先分清问题出在网络、模型还是缓存命中哪一层,再借助用量分析面板缩小范围。遇到反复出现的延迟问题,可以把具体的时间点和请求参数记录下来,对照后台数据一起排查。
常见问题
为什么同一个模型有时候快有时候慢?
可能和上游节点当时的负载情况、是否命中缓存、请求内容长度都有关系,不是恒定不变的固定值,建议观察一段时间的趋势而不是单次请求的耗时。
超时应该设置多少秒合适?
没有统一答案,建议参考目标模型在正常情况下的 P95 响应时间,再留出一定余量,过短容易误判失败,过长会拖慢异常情况下的用户体验。
流式输出和非流式哪个更快?
流式输出通常首字返回更快,用户能更早看到内容,但总耗时和非流式接近;如果业务只关心最终完整结果,两者总耗时差异不大,选择依据主要看交互体验需求。
延迟问题要先联系人工客服吗?
建议先按上文步骤自查,确认是网络、模型选择还是缓存命中的问题;如果用量分析面板显示网关侧确实存在异常波动,再带上具体时间点和请求记录反馈会更容易定位。


评论
登录后可参与评论