RAG 应用里,检索和生成哪个环节更容易被忽视
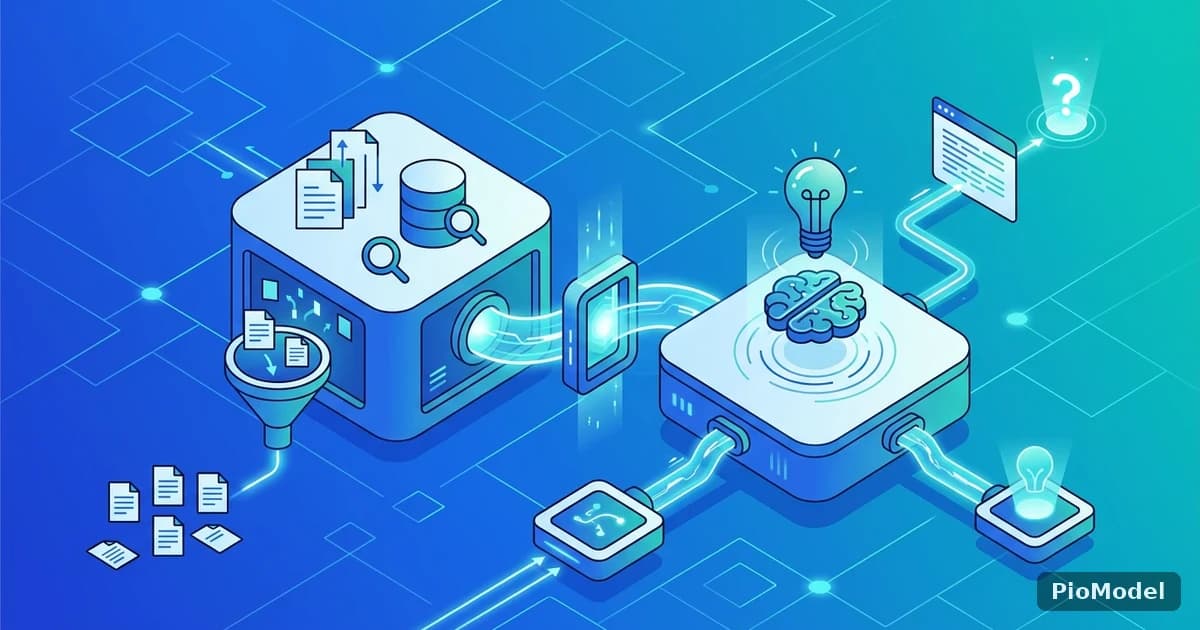
很多人搭 RAG(检索增强生成)应用时,把大部分精力放在怎么切分文档、怎么调向量库上,却把生成环节的模型配置当成随手一填的小事。实际上生成环节的模型选择直接决定了最终答案的可读性和准确性——检索环节找到了对的资料,生成环节的模型如果理解能力不够或者上下文窗口设置错了,答案照样会跑偏。这篇文章按 LLM 层用 PioModel、检索层用 LlamaIndex 标准组件的思路,完整走一遍搭建流程。
整体架构:PioModel 在这套 RAG 应用里承担什么角色
LLM 层:用 OpenAILike 接入
LlamaIndex 提供了一个专门给第三方 OpenAI 兼容接口用的封装类 OpenAILike,只需要传入 api_base(PioModel 的接口地址)、api_key、model,再根据模型是否支持对话格式设置 is_chat_model,就能把 PioModel 已接入的模型接到 LlamaIndex 的查询引擎里,负责根据检索到的资料生成最终回答这一步。
Embedding 层:可以单独选择
Embedding(向量化)负责把文档和问题转成向量用于检索,和负责生成答案的 LLM 是两个独立环节,可以分开选型——检索效果更依赖 Embedding 模型和切分策略,生成质量才主要取决于 LLM,不要把两者的调优思路混在一起。
搭建步骤

加载与切分文档
先用 LlamaIndex 的文档加载器读入你的资料(PDF、Markdown、网页等),再按段落或固定长度切分成一个个小块,切分粒度太大会让检索定位不准,太小又会丢失上下文,通常需要根据文档类型做几轮调整。
构建向量索引
把切分好的文本块交给索引构建流程,生成向量并存入索引结构中,后续查询时会根据问题的向量表示,从索引里找出最相关的若干个文本块。
把查询引擎的 LLM 指向 PioModel
索引构建好之后,在创建查询引擎时把上面配置好的 OpenAILike 实例作为 LLM 参数传入,这样每次查询时,检索到的文本块会连同问题一起交给 PioModel 对应的模型生成最终回答。
实际搭建时容易踩的坑
- 忘记设置 context_window 或设置得比实际模型支持的上下文长度大,导致长文档场景下报错或截断
- is_chat_model 没有设对,把只支持对话格式的模型当成补全模型调用,返回内容格式不符合预期
- api_key 或 api_base 拼写有误导致认证失败或连接失败,这类错误往往在配置阶段就能通过一次简单的测试调用发现
- 切分粒度和检索返回数量(top_k)没有配合调整,检索到的内容要么太碎片化,要么塞满整个上下文窗口
让 RAG 效果更好的几个调优方向
索引建好、能跑通查询只是第一步,真正影响体验的往往是细节调优:适当增加或减少每次检索返回的文本块数量、尝试给检索结果加一层重排序、根据实际问答场景调整提示词让模型更聚焦于只根据检索到的资料回答、不要编造,这几个方向通常比一开始就追求复杂架构更有效。
小结

用 LlamaIndex 搭 RAG 应用时,PioModel 承担的是生成环节的角色,配置本身只需要 OpenAILike 类的几个标准参数。真正决定应用质量的,是文档切分策略、检索参数和提示词这几个环节的持续调优,而不是接入这一步本身。


评论
登录后可参与评论