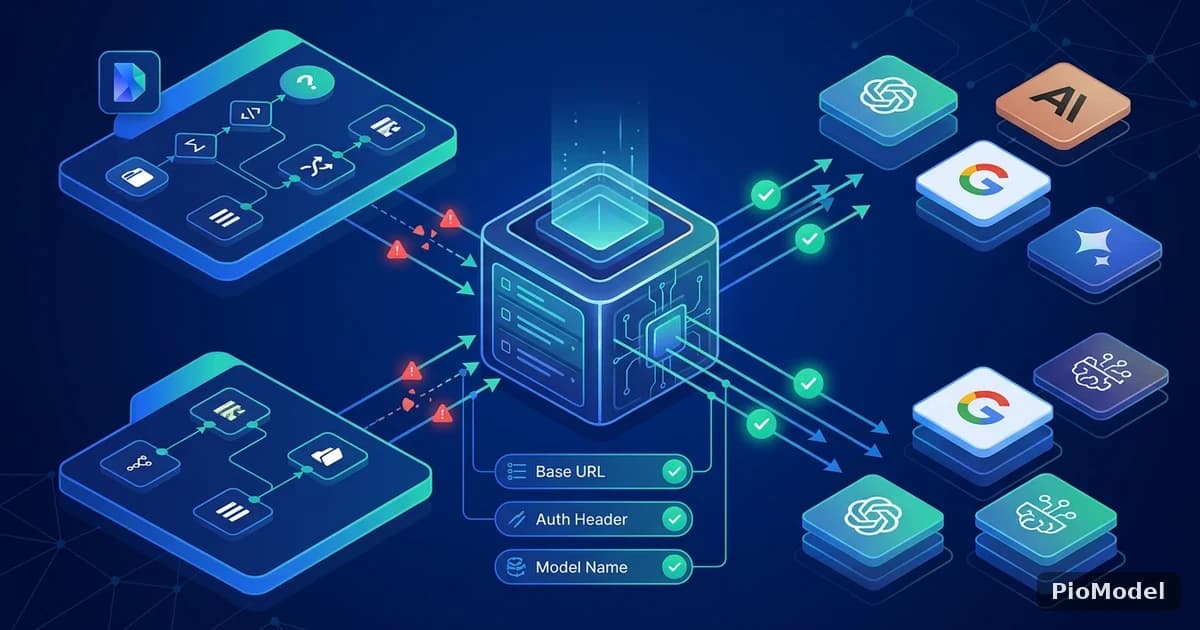
Dify n8n 接入 AI API 网关,卡点通常在三个字段
用 Dify 或 n8n 搭建 AI Agent 工作流时,提示词设计往往不是第一道坎,模型节点里那几个配置框才是。把 OpenAI 官方文档里的参数照抄过去,一换成第三方中转网关就报错,是很多人第一次接入时的真实经历。Dify n8n 接入 AI API 网关这件事,拆开看无非是三个变量——Base URL、鉴权头、模型名,外加一层协议兼容性,三项填对工作流才能跑通,错一项节点就会在执行阶段直接中断,而且报错信息通常不会明说到底是哪一项出了问题。下文按 Dify、n8n 两个平台分别说清楚节点配置步骤,再汇总实际调用中比较容易复现的四类报错。

Dify 与 n8n 的 LLM / AI Agent 节点怎么配置
不管是 Dify 的 LLM 节点,还是 n8n 的 AI Agent 节点,配置逻辑本质上是同一件事:把默认指向官方地址的 Base URL 换成自定义 Base URL,再同步替换鉴权信息和模型标识。后端不管接的是 Claude、GPT、Gemini 还是 AWS Bedrock,节点侧要填的字段都是这三项,差别只在于两个平台把这三项放在了界面的不同位置。
Dify:LLM 节点配置的三个必填字段
Dify 的模型接入入口在「设置 - 模型供应商」,选择 OpenAI-API-compatible 类型的自定义供应商,会看到 API Base URL、API Key、模型名称三个必填框,这也是 Dify LLM 节点配置里比较容易出错的地方。第一个坑是 Base URL 末尾要不要带 /v1——Dify 发起请求时会自动在 Base URL 后面拼接 /chat/completions,如果 Base URL 本身已经写成类似 https://example.com/v1/chat/completions 这种完整路径,再叠加一次拼接就会变成路径重复,上游直接返回 404,而不是更容易联想到的鉴权错误。比较稳妥的做法是 Base URL 只填到域名加 /v1 这一级,把后面的路径交给 Dify 自己处理。第二个坑是模型名称这一栏不是随便填的展示名,它会原样出现在请求体的 model 字段里,如果和网关侧登记的模型别名对不上,请求在网关层就会被拦下,根本到不了上游模型,报错信息也就无从判断具体原因。
n8n:AI Agent 节点背后的 Chat Model 凭据
n8n 的 AI Agent 节点本身不保存网关地址,它依赖挂载在下面的 Chat Model 子节点,比如 OpenAI Chat Model。这个子节点对应的凭据类型里有一个 Base Url 输入框,默认值指向官方地址,把它改成网关地址、API Key 填网关签发的密钥,n8n 会自动在请求头拼上 Authorization: Bearer 前缀,不需要手工处理。如果图省事直接用 HTTP Request 节点手写调用,就必须自己在 Header 里加 Authorization 字段,这里比较容易漏掉 Bearer 后面的空格,或者把整段密钥连同换行符一起粘贴进去,两种情况上游都会判定为鉴权头格式非法。n8n AI Agent 节点在编排多个工具时,底层每一次工具回调其实都会重新触发一次 Chat Model 请求,凭据配置错一次,后面所有工具调用都会跟着失败,排查时容易被误认为是工具本身出了问题。

四类高频报错:鉴权头配置失败、模型名映射错误、超时与预算失控
实际调试 Dify、n8n 工作流接入网关的过程中,以下四类报错在排查记录里出现得比较频繁。延迟表现和报错类型通常是两件事,分开看排查效率更高。PioModel 网关上曾经做过一组实测对照:直连海外上游时首字节延迟经常在 3 到 6 秒之间波动,经网关中转的同一模型请求,连续 50 次调用里有 46 次首字节落在 1.2 秒附近,只有个别请求超过 2 秒——这类数字会随网络状况和模型本身波动,不代表固定承诺,但足够说明中转链路本身不必然拖慢响应。
| 报错现象 | 常见原因 | 排查方向 |
|---|---|---|
| 401 Unauthorized | 鉴权头配置失败:Authorization 缺少 Bearer 前缀,或密钥夹带空格、换行 | 用 curl 单独测一次接口,核对 Header 原始文本,不经过节点封装再判断 |
| model not found / 模型不存在 | 模型名映射错误:节点里填的模型名和网关模型市场里的标识不一致,或用了已下线的旧别名 | 去网关模型列表页直接复制精确名称,不要凭记忆手打或沿用旧文档 |
| 请求超时 | 长上下文或推理型模型响应较慢,超过节点、工作流的默认超时时间 | 按模型类型分别调大超时阈值,推理模型预留比常规对话更长的窗口 |
| 预算超限 / 循环调用 | AI Agent 节点的工具调用没有设置迭代次数上限,陷入重复请求 | 设置 Agent 步数上限,并在网关侧核对金币消耗速度 |
鉴权头配置失败和模型名映射错误,大多是复制粘贴的问题
这两类报错表面上看是两件事,根源却很接近:配置项是从别的地方转抄过来的,而不是从网关侧原样拷贝的。密钥从聊天记录、文档截图里手动打出来,很容易漏字符或多打一个空格;模型名从旧教程或者别的项目配置里直接沿用,而网关侧的模型别名可能已经调整过版本后缀。比较稳妥的做法是每次新建节点时,直接从网关控制台的密钥页面和模型市场页面复制粘贴,不做二次转写,也不依赖记忆输入。
Agent 循环调用为什么容易把预算跑穿
四类报错里,预算超限反而更容易被忽视,因为它本身不报错——工作流表面上在正常执行,ReAct 循环里 Agent 反复调用工具、反复请求模型,直到达到步数上限或者账户余额耗尽才会停下来。Dify 和 n8n 都可以设置 Agent 的迭代次数上限,但不少人为了不打断复杂任务把这个值调得比较宽松,一旦提示词设计有缺陷、模型判断不出任务什么时候该结束,单次工作流触发几十次模型调用完全可能发生。PioModel 按金币计量用量,1 金币对应 1000 厘,不同模型各自有对应的 model_ratio 和 completion_ratio,输入、输出分开计费,一次异常的循环调用会在后台账单里表现成消耗速度陡增,比单纯等超时报错更早能发现问题。
控制这类问题,通常按下面的顺序排查:
- 在 Dify 或 n8n 的 Agent 节点里显式设置迭代次数上限,不要沿用平台默认的宽松值
- 给工具调用增加超时和失败重试上限,避免一个卡住的工具拖累整条循环
- 在网关侧查看分钟级或小时级的金币消耗曲线,提前发现异常陡增的时间点
- 给团队里每个成员单独发一把 Key,而不是共用一个总账户,方便定位是哪条工作流在异常消耗
总结:把网关配置一次做对
Dify、n8n 接入网关的配置核心,是把 Base URL、鉴权头、模型名三项对齐,并给 Agent 设好迭代次数上限。需要统一管理多模型 Key 和用量核算时,可以在 PioModel 里按金币核对每条工作流的实际消耗。


评论
登录后可参与评论