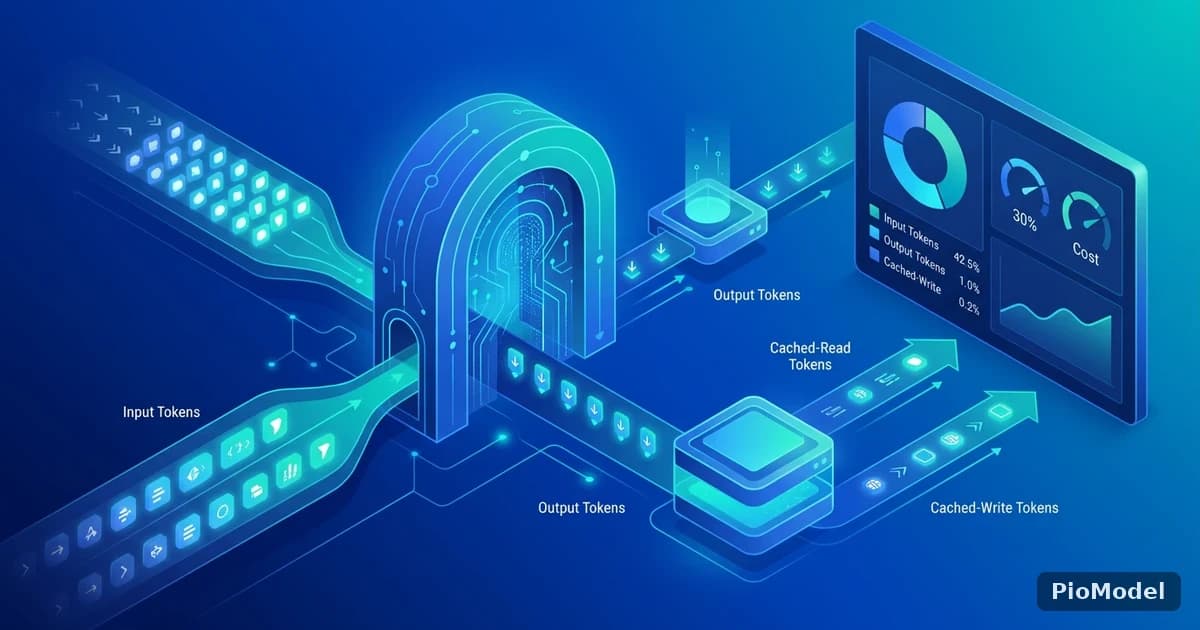
幾乎所有大型語言模型 API 都按 token 計費,但「這次呼叫需要多少費用」很少只得一個數字,因為單一請求可能同時涉及四種計費類型不同的 token:輸入 token、輸出 token,以及部分供應商支援的快取讀取與快取寫入 token。對企業財務規劃而言,搞清楚這四項各自的佔比,是準確預算與帳單超出預期的分別。
Token 的基本概念
Token 是模型的分詞器將輸入文字切分出來的最小單位,可能是一個詞的片段,也可能是完整的短詞。不同模型家族使用的分詞器並不完全相同,因此同一段文字送往不同模型,計算出來的 token 數量亦會有差異。
為何同一段文字在不同模型上計費會有落差?
不同模型家族的分詞器詞彙表不同,如果文字中包含分詞器訓練資料涵蓋較少的語言或符號,切分出來的 token 數量會相應增加,計費亦隨之提高。
輸入與輸出 token 的定價差異
幾乎每一家主流供應商的輸出 token 單價都高於輸入 token,而且往往高出數倍。這反映的是實際運算成本差異:每產生一個輸出 token 都需要完整推論一次,而大批輸入 token 則可以較高效率地平行處理。對企業預算而言,這代表輸入內容多、輸出內容少的任務(例如分類、資訊擷取),即使總 token 數相若,單次呼叫成本也會較低。
這對企業控制成本有何啟示?
容易被忽略的成本槓桿,並非縮短輸入內容,而是限制輸出長度。要求模型回傳結構化、有明確邊界的結果,能直接壓低輸出 token 量——而輸出往往是佔比更高的項目。
快取讀取與快取寫入:企業預算容易遺漏的部分

部分供應商支援提示詞快取:如果同一段長系統提示詞或內容區塊被重複傳送,供應商可在首次請求後將其快取,其後的請求以較低費率讀取快取內容,代價是首次會有一筆快取寫入費用。對於有大量穩定、重複內容的企業應用(例如長系統提示詞、需要反覆查詢的長文件),此舉能有效壓低輸入 token 的整體成本。
何時快取反而不划算?
如果每次請求的內容都不一樣,便沒有可供快取的穩定部分,寫入費用形同虛耗。快取真正划算的情境,是提示詞中有一大段內容會在短時間內被大量重複呼叫。
四種計費類型概覽
| Token 類型 | 相對成本 | 常見來源 |
|---|---|---|
| 輸入(標準) | 基準值 | 每次呼叫重新傳送的系統提示詞、使用者訊息 |
| 輸出 | 輸入的數倍 | 模型產生的所有回應內容 |
| 快取讀取 | 標準輸入的一小部分 | 後續呼叫命中快取的重複內容 |
| 快取寫入 | 略高於標準輸入 | 首次寫入快取的呼叫 |
確切倍率因模型與時間而異,以上僅供理解成本結構之用,確定預算前應以當前實際定價為準。
PioModel 將 Claude、GPT、DeepSeek、GLM、Kimi、通義千問、Llama、Grok 的所有計費,統一放在同一份透明的按量計費帳目上,企業毋須為比較不同模型的成本,分別匯出多份後台資料。


Comments
Sign in to join the discussion