PioModel 多模型路由怎么配置,才能按任务自动选模型?
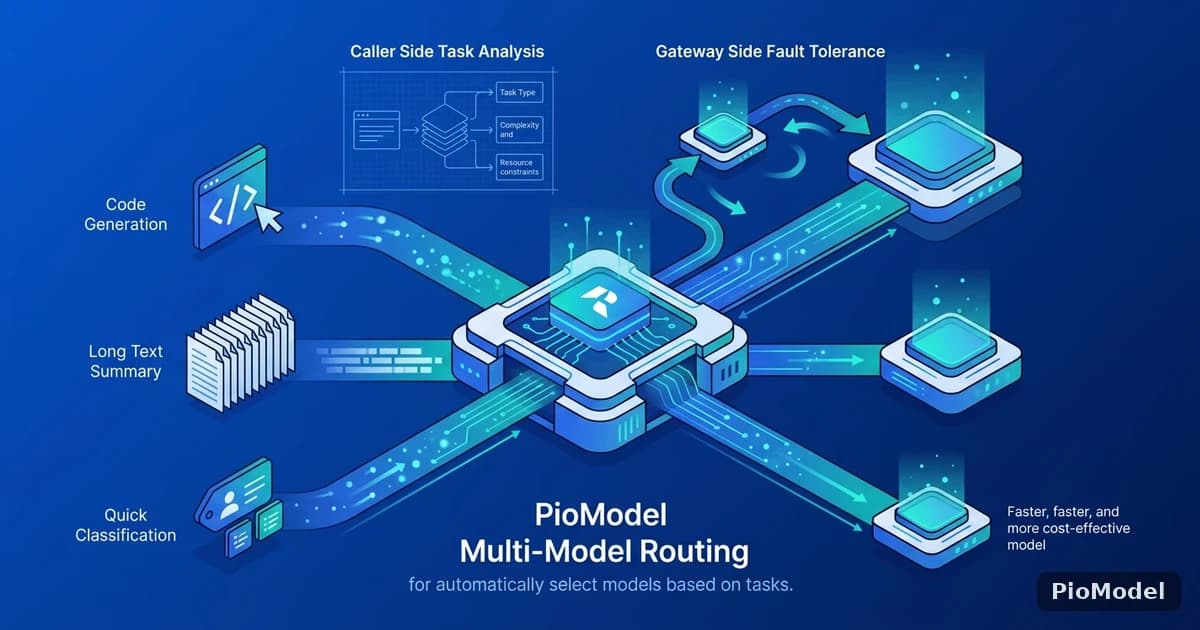
PioModel 用统一的 OpenAI 兼容接口聚合了 GPT、Claude、Gemini 等主流模型,所谓"多模型路由",核心思路是让不同类型的任务自动匹配到最合适的模型,而不是所有请求都写死调用同一个模型。具体做法一般分两层:一层是 PioModel 网关侧对同一模型请求的多通道故障转移,保证单次调用的可用性;另一层是调用方自己在业务代码里,按任务类型、成本预算或延迟要求,决定这次请求该传哪个 model 参数。把这两层分开理解,配置路由时才不会混乱。
为什么需要多模型路由,而不是固定用一个模型
不同任务对模型能力的要求不一样
代码生成、长文本摘要、多语言翻译、简单分类这几类任务,对模型的推理深度和上下文长度要求差异很大。用同一个高倍率的旗舰模型处理所有任务,成本会明显偏高;但如果为了省钱全用轻量模型,复杂任务的输出质量又跟不上。按任务类型分流,是平衡质量和成本最直接的办法。
单一模型的可用性风险
任何一个上游模型都可能出现临时不稳定、限流或者响应变慢的情况,只依赖单一模型意味着这个环节一旦出问题,整条业务链路都会受影响,多模型路由本质上也是在做可用性的冗余设计。
多模型路由的几种常见配置思路
按任务类型分流
最直接的方式是在业务代码里维护一张"任务类型 → 模型"的映射表,比如代码相关任务优先用擅长编程的模型,长文档处理优先用上下文窗口更大的模型,简单问答用响应更快、倍率更低的模型。这张映射表可以写成配置文件,方便后续调整而不用改动业务逻辑本身。
按成本预算分流
对成本敏感的场景,可以设定一个倍率阈值,超过阈值的高倍率模型只在必要时(比如任务复杂度评分较高)才调用,常规请求默认走性价比更高的模型,这样能在不明显牺牲效果的前提下控制整体支出。
按响应延迟要求分流
面向终端用户的实时交互场景(比如聊天机器人)对响应速度敏感,适合优先路由到响应更快的模型;而离线批处理、报告生成这类不要求即时返回的任务,可以路由到质量更高但响应稍慢的模型,不需要为了速度牺牲效果。
结合失败回退(fallback)
路由规则里建议再加一层回退逻辑:首选模型调用失败或超时时,自动改用备选模型重试一次,而不是直接把错误抛给终端用户。PioModel 网关本身对同一模型的多通道故障转移,解决的是"这一路上游不稳定"的问题;业务代码里的模型级 fallback,解决的是"这个模型本身暂时不可用,要不要换个模型"的问题,两者层次不同,建议都配置上。
配置路由时容易踩的坑
- 路由规则写得过细,任务类型分类超过五六种之后维护成本会明显上升,建议先从粗粒度的两三类任务开始,跑一段时间看实际效果再细化
- 只考虑了模型能力,没考虑倍率差异,导致"选对了模型但成本超预算",配置路由表时最好把倍率信息也标注在旁边,一起权衡
- 没有给 fallback 链路设置上限,如果多个备选模型连续失败没有兆底机制,请求会一直重试拖慢整体响应,建议明确设置最大重试次数
- 路由逻辑分散写在多处业务代码里,后续新增模型或调整策略时改动困难,建议集中维护成一份配置
常见问题
多模型路由会不会增加调用延迟?
如果路由判断逻辑只是简单的规则匹配(比如按任务类型查表),增加的延迟基本可以忽略不计;如果路由决策本身依赖额外的模型调用去判断任务复杂度,会引入一次额外请求的耗时,需要权衡这个开销是否值得。
PioModel 支持哪些模型参与路由?
PioModel 聚合了 GPT、Claude、Gemini 等主流模型以及部分国产大模型,具体可路由的模型清单以官网模型列表页实时更新为准。
路由规则应该写在客户端还是服务端?
如果调用方是团队内部多个应用共用同一套路由逻辑,建议统一收敛到服务端一层维护,避免每个客户端各写一套导致规则不一致;单人项目或简单场景写在客户端也没问题。
路由到不同模型后,返回格式会不一致吗?
由于 PioModel 提供的是 OpenAI 兼容接口,不同模型的返回结构基本保持一致,业务代码解析响应时通常不需要为每个模型单独写解析逻辑。
总结
多模型路由的关键不是找一个"万能配置",而是先想清楚任务类型、成本预算和延迟要求这三个维度里,哪个对你的业务最重要,再据此设计分流规则和失败回退逻辑。可以从粗粒度规则起步,结合 PioModel 的实际调用数据逐步细化。


Comments
Sign in to join the discussion