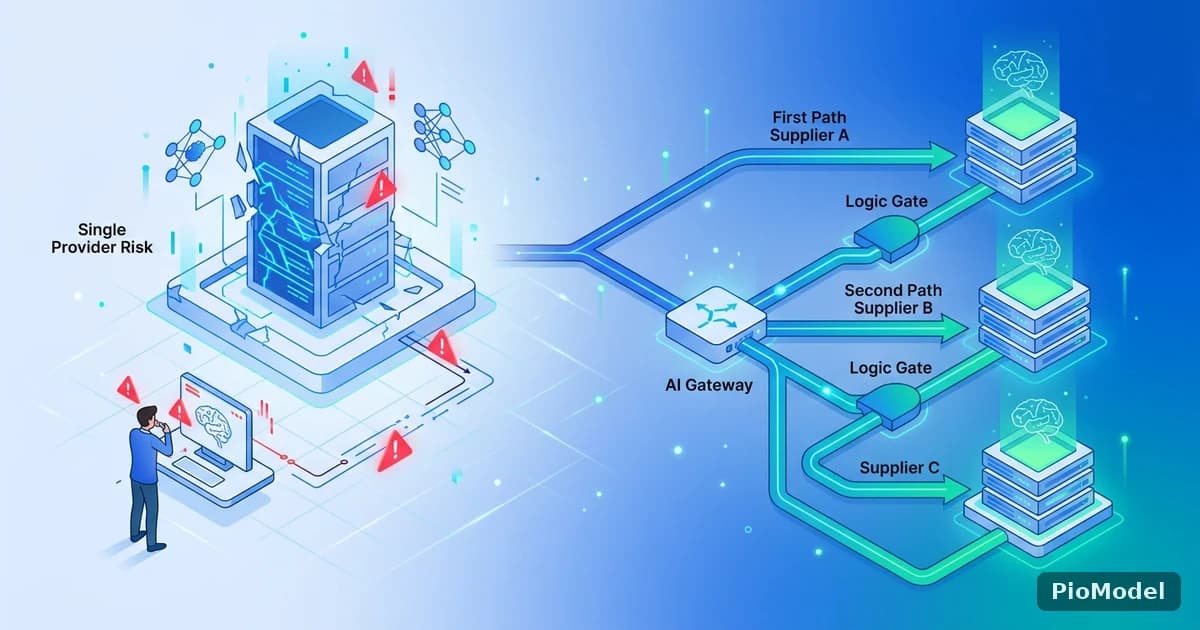
每一家大型語言模型供應商都發生過事故:區域性中斷、延遲異常飆高、流量尖峰時突然收緊的速率限制。這不是在說哪一家供應商特別不可靠,而是「把核心功能完全依賴單一外部服務」這件事本身就帶有風險。真正該問的問題不是「哪家供應商最穩定」,而是「今天最穩定的那家供應商出狀況時,我的服務會發生什麼事」。
單一供應商整合出問題時,實際會發生什麼
如果程式碼直接呼叫單一供應商,而那次呼叫失敗了,後續的表現完全取決於當初有沒有設計因應機制。如果沒有容錯機制,常見狀況是:功能直接報錯、使用者看到一則通用的失敗訊息,而且在上游恢復之前,完全沒有辦法自己復原,也不知道要等多久。
直接重試同一家供應商不能解決問題嗎?
對暫時性的網路抖動來說,重試合理;但對真正的上游中斷或持續的速率限制來說,對著同一個已經出狀況的端點重試,只是在浪費時間(有時候還會浪費額度),不會提高成功機率。
容錯鏈實際上長什麼樣子

容錯鏈其實就是一個排好順序的清單:先試供應商 A;如果失敗(逾時、5xx,或是你事先定義為「可以換一家再試」的錯誤類型),換供應商 B;如果還是失敗,換供應商 C。這個機制不需要設計得很複雜——三層通常就能涵蓋絕大多數真實事故——順序也可以依成本或品質偏好排列,不是只能依可用性排。
這代表每次請求都要跑過容錯邏輯嗎?
不是。多數情況下主要供應商都會成功,容錯層根本不會被觸發。這套機制只在主要供應商狀況不佳的那一小部分請求裡發揮作用——而那正是最需要它的時候。
該用哪種錯誤觸發容錯,是設計上真正的關鍵
哪些狀況才算得上值得容錯的「失敗」?
逾時跟 5xx 錯誤沒有爭議;速率限制(429)也值得觸發容錯,因為在限流視窗內重試同一家供應商幾乎不會有幫助。格式異常但回傳 200 的狀況比較棘手——建議事先決定這算不算容錯觸發條件,還是要走另一條錯誤處理路徑。
容錯用的模型,一定要跟主要模型一樣嗎?
這取決於功能本身的需求。面向使用者的對話功能,可能會希望容錯到品質相近的模型;成本敏感的背景工作,則可能願意容錯到較便宜的模型,前提是「有回應但品質打折」好過「完全沒有回應」。
導入容錯設計後,實際能拿到什麼
- 單一供應商中斷時,請求仍然能成功,不會直接反映到使用者面前。
- 流量尖峰造成的速率限制,可以透過分流到第二家供應商吸收,而不是排隊或直接失敗。
- 容錯層的紀錄本身,等於免費得到一組跟主要供應商即時比較的參考數據。
- 某家供應商調整價格時,不再是全有全無的遷移,因為第二層供應商本來就已經整合並測試過。
為什麼統一整合點會讓這件事變簡單
如果容錯鏈要跨好幾家供應商各自的 SDK 建置,代表每家供應商特有的錯誤處理跟重試邏輯都要分開寫。透過單一 OpenAI 相容閘道,不管實際呼叫的是哪個上游模型,請求跟錯誤格式都維持一致——容錯邏輯變成路由層級的決定,而不是再做一次整合工程。
PioModel 用一組 API Key 跟一致的請求格式串接 Claude、GPT、DeepSeek、GLM、Kimi、通義千問、Llama 與 Grok,讓跨供應商的容錯鏈變成幾行路由邏輯,而不是要額外維護一套 SDK 整合。


Comments
Sign in to join the discussion